국민대학교 화학부 SAIL 연구실(Spectroscopy and AI Lab)은 화학을 위한 인공지능을 연구합니다. 초고속 분광학과 광화학 실험에서 출발한 연구실이지만, 지금은 분자와 빛, 그리고 데이터에 대해 배운 것을 바탕으로 물성과 스펙트럼을 예측하고, 화학 반응을 예측·설명하고, 새로운 분자를 설계하고, 이 모든 것의 바탕이 되는 데이터를 구축하는 모델을 개발합니다. SAIL의 학생들은 화학자와 데이터 과학자, 두 가지 시각을 동시에 배웁니다.
8:26The Convergence of Chemistry and Artificial IntelligenceInterview by Kookmin University, October 2025
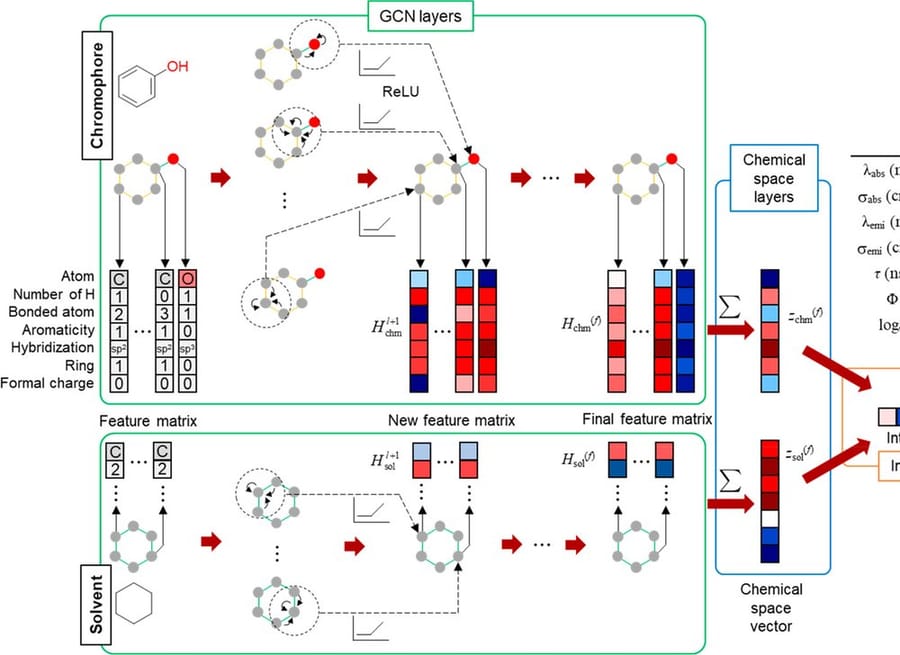
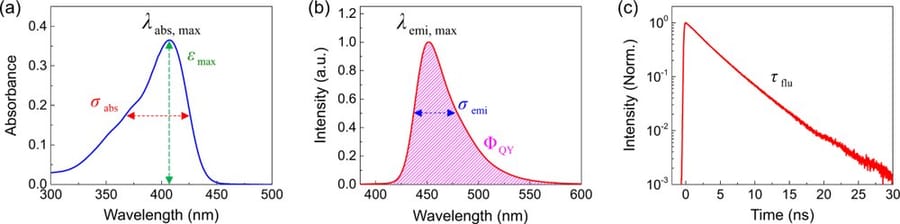
어떤 염료는 파란빛을 내고 어떤 염료는 붉은빛을 내는 이유는 무엇일까요? 어떤 분자는 특정 용매에 잘 녹고 다른 용매에는 녹지 않는 이유는요? 화학자들은 지난 100년 동안 이런 질문에 경험 법칙, 양자화학 계산, 혹은 직접 합성해서 측정하는 방법으로 답해 왔습니다. 그런데 각 방법에는 대가가 따릅니다. 경험 법칙은 만들어진 범위를 벗어나면 틀리고, DFT 같은 계산은 분자 하나에 몇 시간이 걸리며, 합성은 몇 주가 걸립니다. 우리는 실험 데이터로부터 분자 구조와 측정된 물성 사이의 관계를 직접 학습하는 머신러닝 모델을 만들어, 흡수·발광 파장, 에너지 준위, 양자 수율, 용해도 같은 값을 밀리초 만에 추정합니다. 발색단과 용매의 구조로부터 광학 특성을 예측하는 모델을 개발했고, 설명 가능한 모델을 통해 신경망이 발견한 설계 규칙을 거꾸로 읽어내어 고전적인 Woodward–Fieser 규칙을 넘어서는 원리를 찾아내기도 했습니다. 반대 방향의 문제도 다룹니다. 측정된 스펙트럼이 주어졌을 때 시료 안에 무엇이 있는지 알아내는 것인데, 라만 스펙트럼을 위한 파수 인식(wavenumber-aware) 딥러닝은 숙련된 분광학자처럼 스펙트럼을 읽는 AI를 향한 첫걸음입니다. 이 분야의 학생들은 데이터 뒤에 숨은 물리를 먼저 배우고, 그 물리를 모델이 존중하도록 만드는 법을 배웁니다.
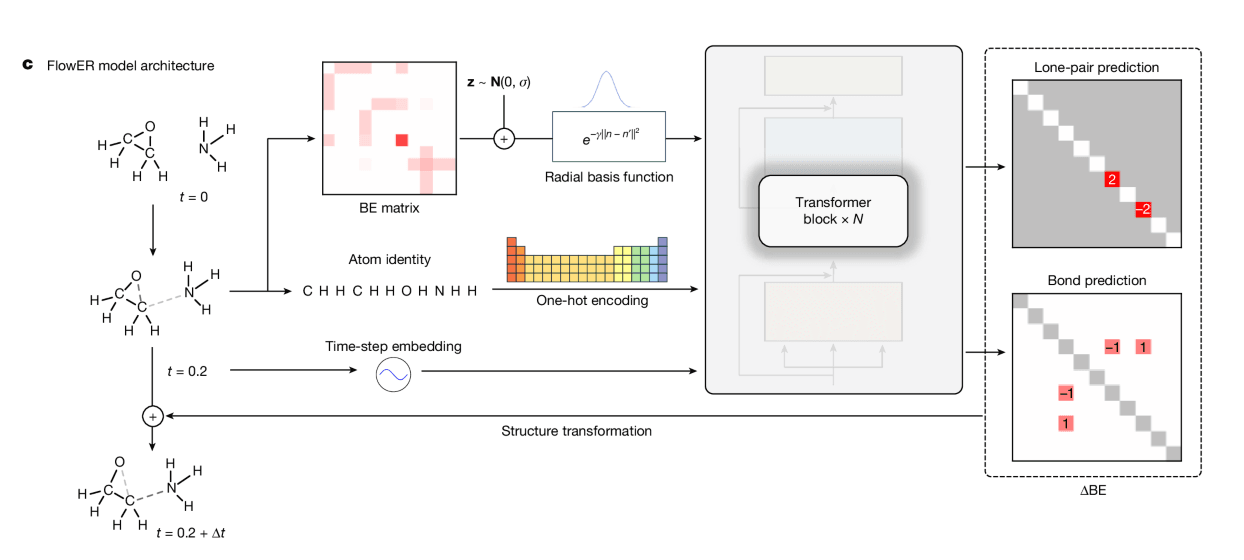
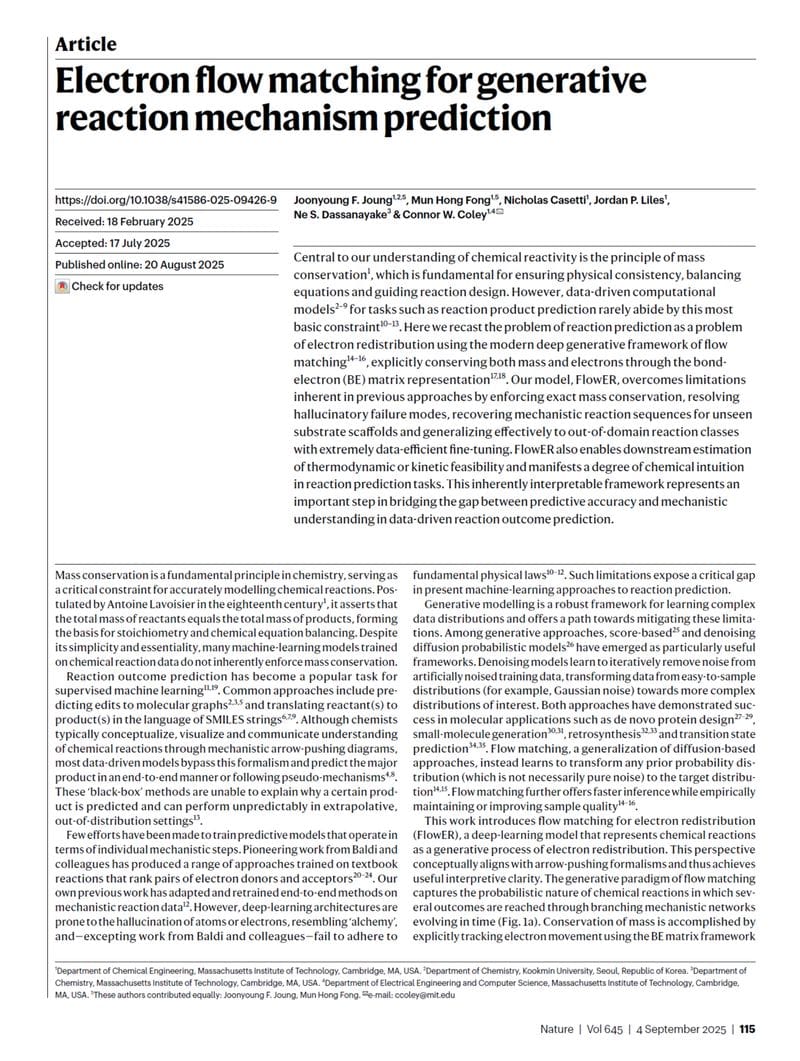
두 시약을 섞으면 무엇이 나올까요? 화학에서 가장 기본적인 질문처럼 들리지만, 사실 믿을 만하게 답하기 가장 어려운 질문 중 하나입니다. 교과서는 주생성물을 알려주지만, 플라스크 안에서는 부생성물과 불순물, 그리고 가끔은 아무도 예상하지 못한 것이 함께 나옵니다. 이런 지식은 전통적으로 숙련된 화학자의 머릿속과 손으로 쓴 반응 규칙 안에 있었고, 새로운 분자에는 잘 일반화되지 않았습니다. 우리는 다른 길을 택합니다. 반응이 어떻게 진행되는지를 모델이 데이터로부터 직접 배우게 하는 것입니다. 최종 생성물만 예측하는 대신, 반응물에서 생성물에 이르기까지 전자가 어떻게 이동하는지 단계별 메커니즘을 예측합니다. 2025년 Nature에 발표한 전자 흐름 매칭(electron flow matching) 모델 FlowER는 질량과 전자 보존 법칙을 지키면서 메커니즘 경로를 생성하기 때문에 예측이 물리적으로 일관되고, 화학자가 직접 검증할 수 있으며, 예상치 못한 불순물이 어디서 왔는지도 설명할 수 있습니다. 메커니즘을 이해하는 모델은 알려진 화학을 재현하는 데서 그치지 않습니다. 우리의 궁극적인 목표는 이런 모델로 아직 보고되지 않은 반응을 발견하는 것입니다. 새로운 변환을 제안하고, 그것이 왜 일어나야 하는지 설명하고, 실험실에서 직접 확인하는 것이죠. 학생에게 이 분야는 유기화학과 그래프 이론, 생성 모델이 만나는 지점이며, 화면 위의 예측이 플라스크 속 반응으로 바뀌는 곳입니다.
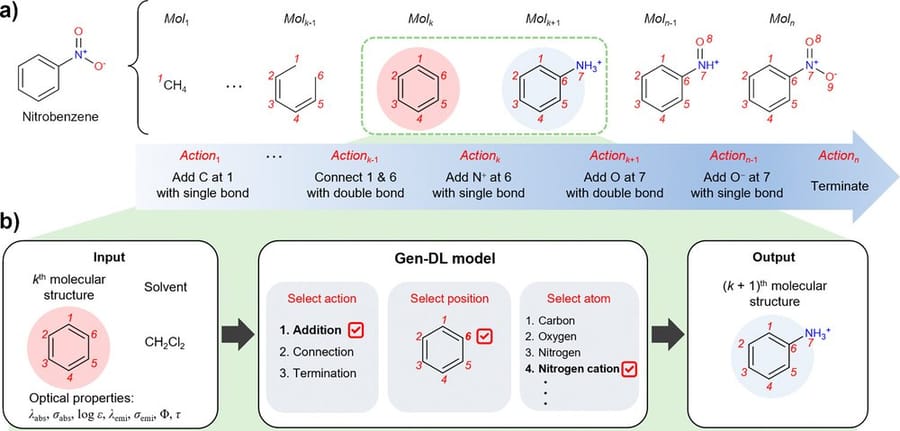
예측은 "이 분자는 어떤 성질을 가질까?"에 답합니다. 설계는 더 어려운 질문을 던집니다. "그래서 어떤 분자를 만들어야 할까?" 가능한 약물 유사 분자의 수는 10^60개가 넘는 것으로 추정되므로, 어떤 실험실도 이를 시행착오로 탐색할 수는 없습니다. 우리는 데이터와 머신러닝으로 이 공간을 영리하게 탐색하며, 서로 보완적인 세 가지 방법을 씁니다. 첫째는 가상 스크리닝입니다. 빠른 물성 예측 모델로 거대한 후보 라이브러리를 훑어 가장 유망한 분자만 합성 단계로 넘기는 방식으로, 진청색 OLED의 호스트와 발광체를 사전 선별한 연구가 그 예입니다. 둘째는 생성 기반 설계입니다. 기존 목록을 걸러내는 대신, 생성형 딥러닝 모델이 목표 특성을 가질 것으로 기대되는 새로운 분자 구조를 직접 제안하며, 원하는 광학 특성을 갖는 유기 분자 설계로 이를 보였습니다. 셋째는 설계 원리의 도출입니다. 설명 가능한 모델과 양자화학 분석으로 어떤 구조가 왜 작동하는지를 끄집어내어, 블랙박스의 제안을 화학자가 다시 쓸 수 있는 규칙으로 바꿉니다. 이 분야의 재미는 모델의 제안이 이야기의 끝이 아니라는 데 있습니다. 제안된 분자는 실제로 합성되고 측정되어 다시 데이터로 돌아오며, 계산과 실험 사이의 고리가 닫힙니다.
위의 모든 모델은 학습한 데이터만큼만 좋을 수 있는데, 화학에서 좋은 데이터는 귀합니다. 측정값들은 수십 년치 논문에 제각각의 형식으로 흩어져 있고, 조건이 빠져 있거나 간혹 오류도 있습니다. 깨끗하고 잘 정리된 데이터셋을 만드는 일은 느리고 화려하지 않지만, 한 연구실이 분야 전체에 기여할 수 있는 가장 가치 있는 일 중 하나입니다. 우리는 문헌에서 수만 건의 발색단–용매 조합을 정리한 유기 화합물 광학 특성 실험 데이터베이스를 구축했고, 이는 이후 광학 특성 예측의 표준 학습 데이터로 자리 잡았습니다. 반응 예측을 위해서는 모델이 생성물의 정체만이 아니라 전자의 움직임을 배울 수 있도록 대규모 메커니즘 데이터셋을 구축했습니다. 데이터보다 앞서는 질문도 고민합니다. 어떤 화학 문제가 실제로 AI에 적합하게 정의된 문제인지, 성공은 어떻게 측정해야 하는지 하는 질문인데, AI 모델을 위한 화학 문제 정의에 관한 연구와 KRICT ChemDX 해커톤 같은 커뮤니티 활동이 그 주제입니다. 이 분야의 학생들은 데이터 큐레이션과 화학정보학, 그리고 의미 있는 벤치마크와 오해를 부르는 벤치마크를 구별하는 안목을 배우는데, 이는 AI가 과학과 만나는 모든 곳에서 필요한 역량입니다.